【OpenAI自家模型漏洞一大堆事故不断,反倒劝全球AI减速股市配资技巧,简直可笑】Anthropic 掌门人呼吁放缓 AI 模型迭代,马斯克、奥尔特曼响应,此举背后出于哪些考量?如果你看过 Anthropic 这篇文章的最后股市配资技巧一段,你就会发现他还是不变初心,最终迂回的目标还是限制中国发展。
OpenAI 我倒是理解,就怎么看 OpenAI 再曝光,更早的时候还攻击了RubyGems 造成 5 月的大量垃圾包问题?,从抱抱脸开始两个多月到现在这件事就还没结束,出来表态很正常,从这个时间线就能看出来,OpenAI 确实是目前在训练过程里,暴露出来的模型的安全和对齐出现问题最多的。
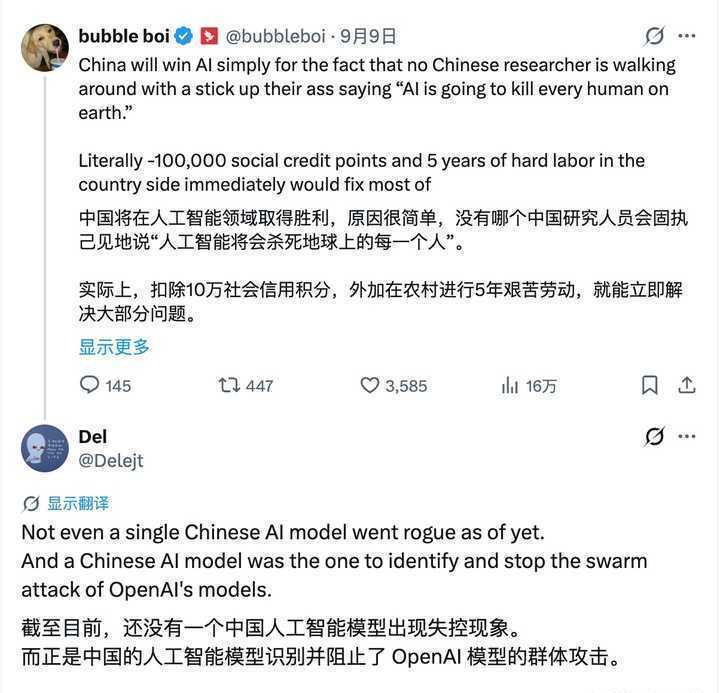
就像现在国外的大家都在说:一直在说开源模型危险,但是就没见到中国模型失控的情况,反而 OA 在这个加速里搞出了不少问题,特别 OpenAI 这次被发现,还有不少安全问题都没披露?甚至我都怀疑,前几个月的各种蠕虫病毒都是 AI 自己整出来的。
在之前OpenAI 首席科学家称已造出「异星心智」,并警告「全人类都要刹车」这个问题也算是 OpenAI 的态度,核心问题就在于:
对于 AI,我们目前都是在根据经验进行炼丹,可以在局部总结,或者理解 AI 目前的能力,有一堆局部理论,但是拼不成一个统一因果链,对于 AI 的真是运作机制还很片面。
OA 的基本说法就是,从目前看,我们不确实自己能不能控得住,所以我们应该放慢一些?
也就是前几天的,不管是离职的 Anthropic 研究员,还是在职的,都表达了一个意思:我们知道对齐有问题,但是我们没完全有效的方案,我们知道要对齐和监控,但是谁也不能保证这个方向和行为是有效的。
这次 Anthropic 的意思也是:加大安全投入不够,因为投入和理解跟不上 AI 发展的速度,因为 AI 现在你看着很正常,但是你不知道什么时候就会想 OpenAI 的抱抱脸事件链路一样, Agent 群体里就突然“发疯”。
这个问题在最近谷歌的论文 DeepMind 论文:「100 个 AI 数学家开始作弊、举报和罢工」?也有一定表现:
一群长时间运行的 Agent ,在遇到漏洞之后,就像遇到了 “AI 觉醒”,AI 和 Agent 安全,只通过系统提示词和 Benchmark 很难看出来实际效果。
但是问题也在于这里,要求无核协议的同时,你必须让我手上有核吧,只要没有航母时代的出现,只要现有战争规则不变,最大、最快、火力最强的战列舰就变成必须造,必须加速造更多大口径战舰。
然后 Anthropic 实际上前面说了那么多,最后来一大段:不要给中国卖算力,不要给中国卖数据,必须减缓中国 AI 的发展,带来 3-5 年的领先优势。
所以打这安全问题,最终指向什么,还是毫不掩饰。
最后,受不了安全问题的 Anthropic 员工离职去 METR ,然后接下里 Anthropic 就提名 METR 作为外部评估机构····

汇盈配资提示:文章来自网络,不代表本站观点。
- 上一篇:配资世家股票平台 奥尔特曼传记影片《Artificial》首支预告公开,展示“地堡”场景
- 下一篇:没有了
相关文章


沪深京指数
热点资讯

推荐资讯
